EF Core: problemas de rendimiento que aparecen en producción
Con pocos datos EF Core es rápido. Con millones de filas aparecen consultas que traen todo, explosiones cartesianas y paginaciones lentas. Cómo corregirlos.
Entity Framework Core nos permite trabajar con SQL desde C#, pero esa comodidad tiene un precio: es fácil olvidar qué consulta termina ejecutándose en la base de datos.
En una aplicación pequeña probablemente nunca sea un problema. Con mil registros, casi cualquier consulta responde rápido. Cuando crecen los datos y el tráfico, esa abstracción puede esconder consultas muy costosas. Y como la base de desarrollo tiene diez filas por tabla, esos problemas no se ven hasta producción.
Antes de todo: mira el SQL
No se puede optimizar lo que no se ve. En desarrollo, registra cada consulta:
builder.Services.AddDbContext<AppDbContext>(options =>
{
    options.UseSqlServer(connectionString);

    if (builder.Environment.IsDevelopment())
    {
        options.LogTo(Console.WriteLine, LogLevel.Information)
               .EnableSensitiveDataLogging(); // muestra valores de parámetros: solo en desarrollo
    }
});
Para una consulta concreta, ToQueryString() devuelve el SQL sin ejecutarla:
var query = db.Orders.Where(o => o.CustomerId == id).OrderByDescending(o => o.CreatedAt);
Console.WriteLine(query.ToQueryString());
Y TagWith agrega un comentario al SQL que luego encuentras en el Query Store o en el monitoreo:
var orders = await db.Orders.TagWith("Dashboard: últimos pedidos")...
Problema 1: traer la entidad completa para mostrar tres campos
// ❌ Trae todas las columnas, incluidas las nvarchar(max), y las rastrea
var orders = await db.Orders
    .Where(o => o.CustomerId == id)
    .ToListAsync(ct);

return orders.Select(o => new OrderSummary(o.Id, o.CreatedAt, o.Total));

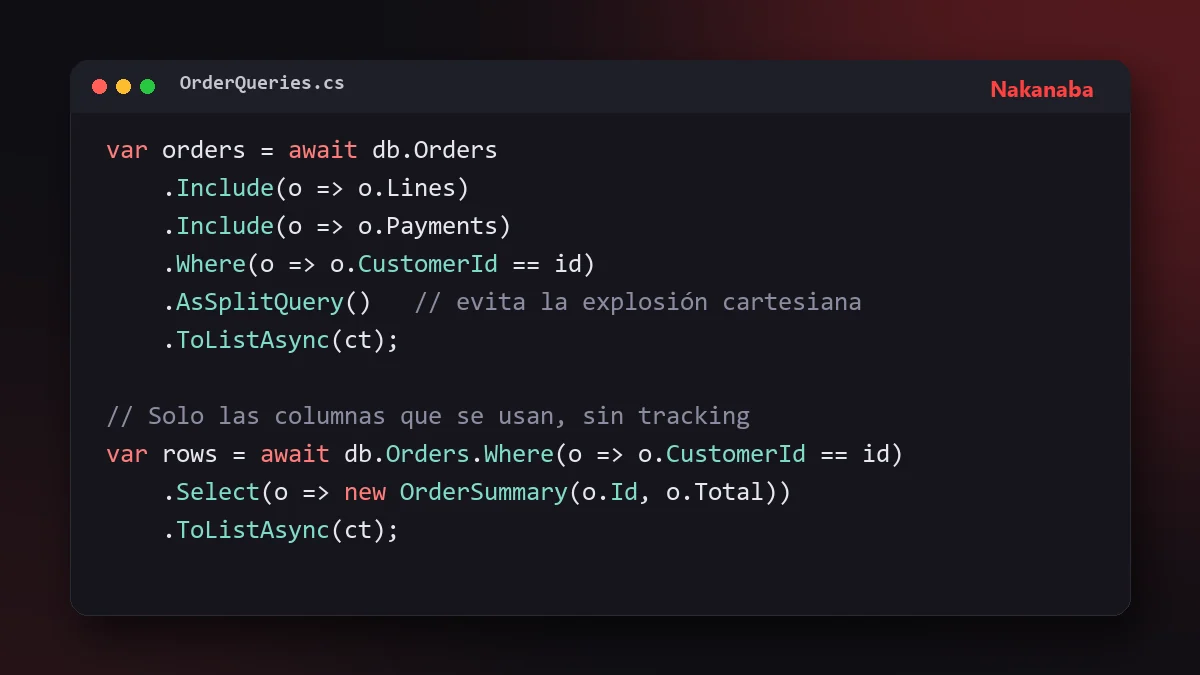
// ✅ Solo las columnas que se usan, sin tracking
var orders = await db.Orders
    .Where(o => o.CustomerId == id)
    .Select(o => new OrderSummary(o.Id, o.CreatedAt, o.Total))
    .ToListAsync(ct);
La proyección con Select reduce lo que viaja por la red, permite que SQL Server use índices que cubren la consulta y evita el costo del change tracker. En listados y reportes, es probablemente la optimización con mejor relación costo-beneficio.
Problema 2: filtrar después de ToListAsync
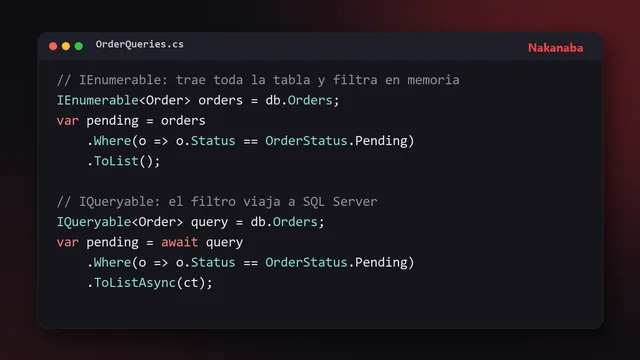
// ❌ Trae la tabla completa a memoria y filtra en C#
var active = (await db.Products.ToListAsync(ct))
    .Where(p => p.IsActive && p.Stock > 0);
Parece obvio leído así, pero en código real aparece repartido: un método del repositorio devuelve List<T> y otro aplica el filtro. Todo lo que va antes de ToListAsync, FirstAsync o CountAsync se traduce a SQL; lo que va después se ejecuta en memoria.
Problema 3: la explosión cartesiana
var orders = await db.Orders
    .Include(o => o.Lines)
    .Include(o => o.Payments)
    .Where(o => o.CustomerId == id)
    .ToListAsync(ct);
EF Core genera un solo JOIN con las dos colecciones. Un pedido con 20 líneas y 3 pagos devuelve 60 filas con los datos del pedido repetidos en cada una. Con cientos de pedidos, la consulta mueve megabytes de datos duplicados.
EF Core avisa de esto con una advertencia en el log. La solución es dividir la consulta:
var orders = await db.Orders
    .Include(o => o.Lines)
    .Include(o => o.Payments)
    .Where(o => o.CustomerId == id)
    .AsSplitQuery()
    .ToListAsync(ct);
AsSplitQuery ejecuta una consulta por colección. El trade-off: son varios viajes a la base de datos y, sin una transacción, los datos podrían cambiar entre una consulta y otra. Para pocas filas, la consulta única suele ser mejor. Para colecciones grandes, dividir gana por mucho.
Problema 4: lazy loading y el N+1
Con lazy loading activado, recorrer una colección dispara una consulta por cada elemento:
foreach (var order in orders)          // 1 consulta
    total += order.Customer.CreditLimit; // + 1 consulta por pedido
Con 500 pedidos son 501 consultas. En desarrollo, contra una base local, tarda 300 ms y nadie lo nota. En producción, con latencia de red, son segundos. Lo vemos en detalle en el artículo sobre el problema N+1. En la mayoría de APIs, desactivar el lazy loading y cargar explícitamente con Include o proyecciones evita toda esta categoría de errores.
Problema 5: paginar con Skip en tablas grandes
var page = await db.Orders
    .OrderBy(o => o.Id)
    .Skip(pageNumber * 50)
    .Take(50)
    .ToListAsync(ct);
Skip(500000) obliga a SQL Server a leer y descartar 500.000 filas antes de devolver 50. La página 1 es rápida; la página 10.000, no. Para listados largos o infinitos, la paginación por clave (keyset) es mucho más estable:
var page = await db.Orders
    .Where(o => o.Id > lastSeenId)
    .OrderBy(o => o.Id)
    .Take(50)
    .ToListAsync(ct);
La contrapartida es que no permite saltar a la página 37 directamente. Para una tabla administrativa con números de página, Skip/Take es aceptable; para un feed o una exportación, keyset.
Problema 6: actualizar miles de filas una por una
// ❌ Carga cada entidad, la modifica y genera un UPDATE por fila
var expired = await db.Coupons.Where(c => c.ExpiresAt < now).ToListAsync(ct);
foreach (var c in expired) c.IsActive = false;
await db.SaveChangesAsync(ct);

// ✅ Un solo UPDATE en la base de datos (EF Core 7+)
await db.Coupons
    .Where(c => c.ExpiresAt < now)
    .ExecuteUpdateAsync(s => s.SetProperty(c => c.IsActive, false), ct);
ExecuteUpdateAsync y ExecuteDeleteAsync no pasan por el change tracker: no ejecutan la lógica que tengas en SaveChanges ni actualizan entidades ya cargadas en el contexto. Para operaciones masivas, es exactamente lo que quieres; para cambios con reglas de negocio por entidad, no.
Problema 7: Contains con listas enormes
var products = await db.Products.Where(p => ids.Contains(p.Id)).ToListAsync(ct);
Con 20 IDs no hay problema. Con 20.000, la consulta generada se vuelve enorme y puede superar el límite de parámetros de SQL Server o generar un plan distinto por cada tamaño de lista. Para volúmenes grandes conviene enviar los IDs como un parámetro de tabla o en lotes.
El trade-off de EF Core
Ninguno de estos problemas es un defecto de EF Core. Son el costo de una abstracción que oculta el SQL. A cambio, se gana productividad, consultas tipadas y migraciones. La clave es no perder de vista el SQL generado en las consultas que importan.
Cuándo no usar EF Core para una consulta
Reportes con agregaciones complejas, consultas con window functions o procesos de carga masiva suelen quedar más claros y rápidos en SQL directo, con FromSql o con Dapper junto a EF Core. Usar las dos herramientas en el mismo proyecto es perfectamente razonable.
Conclusión
EF Core rara vez es lento por sí mismo. Lo que se vuelve lento es la consulta que nadie revisó: la que trae columnas de más, la que filtra en memoria o la que repite datos en cada fila. Revisa el SQL de los endpoints con más tráfico antes de que lo haga producción por ti.


¿Necesitas un equipo .NET para tu proyecto?
Construimos y modernizamos backends en .NET y SQL Server: APIs, integraciones y sistemas empresariales a medida.
Ver desarrollo a medida