¿Realmente necesitas Clean Architecture?
Clean Architecture resuelve problemas reales, pero aplicada sin contexto multiplica capas y archivos. Cuándo ayuda, cuándo sobra y qué hacer en medio.
Abres una solución nueva y ya tiene cuatro proyectos: Domain, Application, Infrastructure y Api. Para agregar un campo a un formulario hay que tocar la entidad, un DTO, un comando, su handler, su validador, un perfil de mapeo, una interfaz de repositorio y su implementación. Ocho archivos para una columna.
Clean Architecture no es el problema. El problema es aplicarla como plantilla por defecto, sin preguntarse qué problema resuelve.
Qué promete Clean Architecture
La idea central es una sola regla: las dependencias apuntan hacia adentro. El núcleo (las reglas de negocio) no conoce la base de datos, el framework web ni los servicios externos. Esas piezas dependen del núcleo, no al revés.
Api ──────────┐
              ▼
Infrastructure → Application → Domain
De esa regla salen beneficios reales:
- Reglas de negocio que se pueden probar sin infraestructura. Puedes probar el cálculo de una factura sin base de datos ni HTTP.
- Cambiar la infraestructura sin tocar el negocio. Pasar de un proveedor de correo a otro, o de SQL Server a otro motor, afecta a una capa.
- Límites claros en equipos grandes. Cada capa tiene responsabilidades que se pueden revisar en un pull request.
Dónde se convierte en sobreingeniería
Cuando no hay reglas de negocio que proteger
Muchas aplicaciones son, en esencia, formularios sobre una base de datos: crear, listar, editar, aprobar. Si el "dominio" son entidades con propiedades y la lógica es "guardar lo que llega", la capa de dominio queda vacía y la de aplicación solo pasa datos de un lado a otro.
// Un handler que no hace nada más que delegar
public async Task<Guid> Handle(CreateCategoryCommand cmd, CancellationToken ct)
{
    var category = new Category(cmd.Name);
    await _repository.AddAsync(category, ct);
    await _unitOfWork.SaveChangesAsync(ct);
    return category.Id;
}
Tres abstracciones para un INSERT. Cada una necesita su interfaz, su registro en el contenedor y su mock en las pruebas.
Cuando las abstracciones esconden la tecnología que sí importa
Un IRepository<T> genérico sobre EF Core esconde justo lo que necesitas controlar para el rendimiento: proyecciones, Include, tracking, consultas compiladas. Termina creciendo con métodos como GetWithLinesAndCustomerAndPaymentsAsync, o exponiendo IQueryable, que rompe la abstracción que se quería proteger.
Cuando "cambiar la base de datos algún día" es la única justificación
En la práctica, pocas aplicaciones cambian de motor de base de datos. Y cuando lo hacen, la capa de repositorios rara vez es lo más difícil: lo son las consultas, los tipos de datos, las transacciones y los datos mismos. Diseñar toda la aplicación para un cambio que probablemente no ocurra es pagar un seguro caro.
Lo que sí conviene conservar
No hace falta elegir entre "cuatro proyectos" y "todo en el controlador". Hay un punto medio que mantiene lo valioso:
- Reglas de negocio fuera de los controladores. En clases que se puedan probar.
- Dependencias externas detrás de una interfaz cuando hay una razón concreta: correo, pagos, almacenamiento de archivos, APIs de terceros. Son las que cambian y las que necesitas simular en pruebas.
- EF Core usado directamente desde los casos de uso, sin repositorio genérico encima.
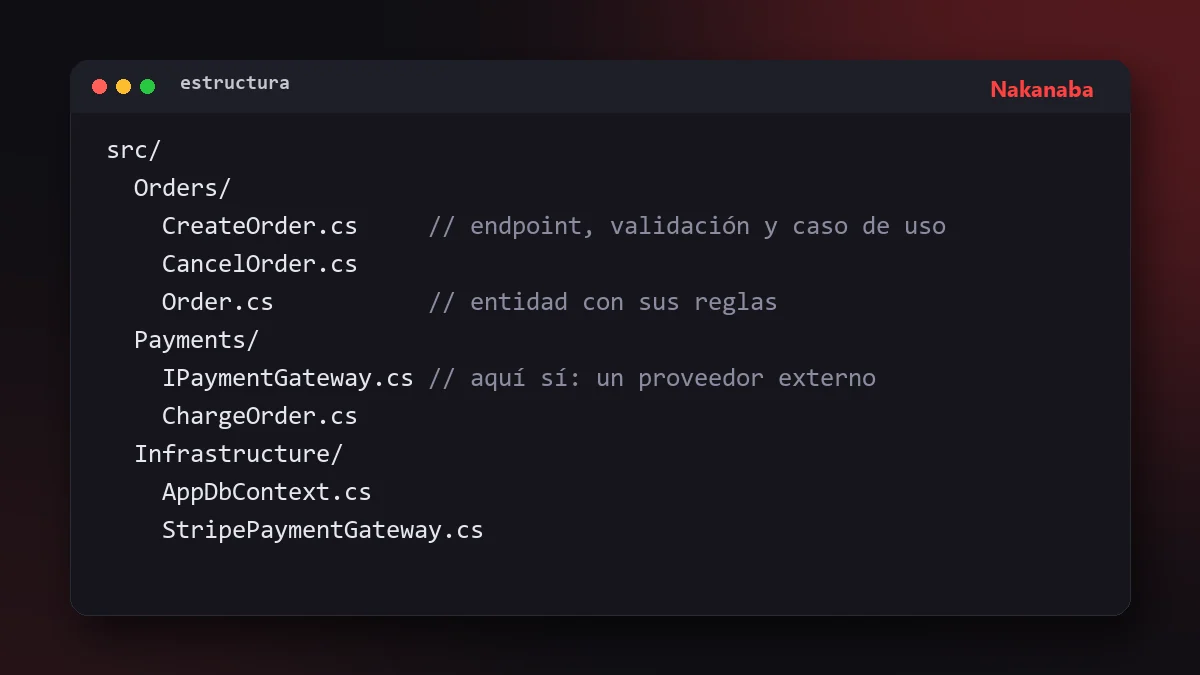
- Organización por funcionalidad, no por tipo técnico. Todo lo de "pedidos" junto, en lugar de una carpeta de Handlers con 200 archivos.
src/
  Orders/
    CreateOrder.cs          // endpoint, request, validación y lógica del caso de uso
    CancelOrder.cs
    Order.cs                // entidad con sus reglas
  Payments/
    IPaymentGateway.cs      // interfaz: aquí sí hay un proveedor externo
    ChargeOrder.cs
  Infrastructure/
    AppDbContext.cs
    StripePaymentGateway.cs
Este enfoque, conocido como vertical slices, mantiene la regla importante (el negocio no depende de los detalles) con muchos menos archivos.
Cuándo sí usar Clean Architecture completa
- Dominio complejo: reglas de negocio con muchas condiciones, cálculos y estados (facturación, seguros, logística, finanzas).
- Sistemas que vivirán muchos años y serán mantenidos por varios equipos.
- Varias interfaces sobre el mismo núcleo: una API, un worker, una aplicación de escritorio y un proceso por lotes usando las mismas reglas.
- Equipos grandes que necesitan límites explícitos para no pisarse.
Cuándo no usarla
- APIs que son principalmente CRUD.
- Equipos de una a tres personas en un producto que todavía está buscando su forma.
- Microservicios pequeños con una sola responsabilidad: separarlos en cuatro proyectos dentro de un servicio de 2.000 líneas es arquitectura por costumbre.
- Cuando nadie en el equipo puede explicar qué problema concreto resuelve cada capa en ese proyecto.
El trade-off
Clean Architecture cambia velocidad de cambio hoy por facilidad de cambio mañana. Si el mañana llega (el sistema crece, el dominio se complica, cambian proveedores), la inversión se recupera. Si no llega, pagaste el costo de cada capa en cada funcionalidad sin recibir nada a cambio.
Lo bueno es que no es una decisión irreversible. Es más fácil extraer una capa cuando aparece la necesidad que eliminar capas que nunca la tuvieron.
Conclusión
La pregunta no es si Clean Architecture es buena, sino si tu sistema tiene hoy el problema que resuelve. Empieza con la regla que importa (el negocio no depende de los detalles) y agrega estructura cuando el código te la pida, no antes.


¿Tu sistema necesita una revisión de arquitectura?
Te ayudamos a decidir qué estructura necesita tu software hoy y cómo prepararlo para crecer, sin sobreingeniería.
Ver desarrollo a medida