Cómo diseñar APIs preparadas para alta concurrencia
Con 10 usuarios todo funciona; con 2.000 simultáneos aparecen pools agotados, datos pisados y bloqueos. Decisiones en .NET para soportar concurrencia real.
Una venta especial empieza a las 8:00. A las 8:01 hay 2.000 usuarios intentando comprar el mismo producto. La API, que en las pruebas respondía en 50 ms, empieza a devolver errores de timeout. Cuando se revisan los datos, se vendieron 140 unidades de un producto que tenía 100 en stock.
La concurrencia alta no solo pone a prueba el rendimiento. Pone a prueba la corrección: código que funciona perfectamente con un usuario puede producir datos incorrectos con mil a la vez.
1. Sin estado en la instancia
La primera condición para escalar horizontalmente es que cualquier instancia pueda atender cualquier petición:
- Nada de sesiones en memoria: autenticación con tokens o sesiones en un almacén compartido.
- Nada de cachés locales que deban ser coherentes entre instancias (o caché distribuida, como vimos en MemoryCache vs caché distribuida).
- Nada de archivos temporales en el disco local que otra petición necesite leer.
Con eso, agregar capacidad es agregar instancias.
2. Asíncrono de punta a punta
Bajo alta concurrencia, el thread pool es un recurso escaso. Cada .Result o .Wait() ocupa un hilo sin hacer nada, y el pool se agota con mucho menos tráfico del que la CPU podría atender. Lo explicamos en errores comunes con async/await.
3. Respeta los límites de los recursos compartidos
La API escala con instancias. La base de datos, normalmente, no tanto. El pool de conexiones de ADO.NET tiene un máximo por defecto de 100 conexiones por cadena de conexión y por proceso. Con 10 instancias, son hasta 1.000 conexiones contra el mismo SQL Server.
- Usa la conexión el menor tiempo posible. Nada de trabajo de CPU, llamadas HTTP o esperas con una conexión abierta.
- Mide antes de subir
Max Pool Size. Si el pool se agota, casi siempre es porque las conexiones se retienen demasiado tiempo, no porque falten. - Limita la concurrencia hacia lo costoso. Un limitador por concurrencia (rate limiting) sobre los endpoints más pesados evita que 500 peticiones simultáneas a un reporte ahoguen la base de datos.
4. Las validaciones de "leer y luego escribir" no son seguras
El caso del stock:
// ❌ Dos peticiones leen Stock = 1 al mismo tiempo; las dos venden
var product = await db.Products.FirstAsync(p => p.Id == id, ct);
if (product.Stock < quantity) return Results.Conflict("Sin stock");

product.Stock -= quantity;
await db.SaveChangesAsync(ct);
Entre la lectura y la escritura hay una ventana en la que otra petición puede hacer lo mismo. Con 2.000 usuarios, esa ventana se usa.
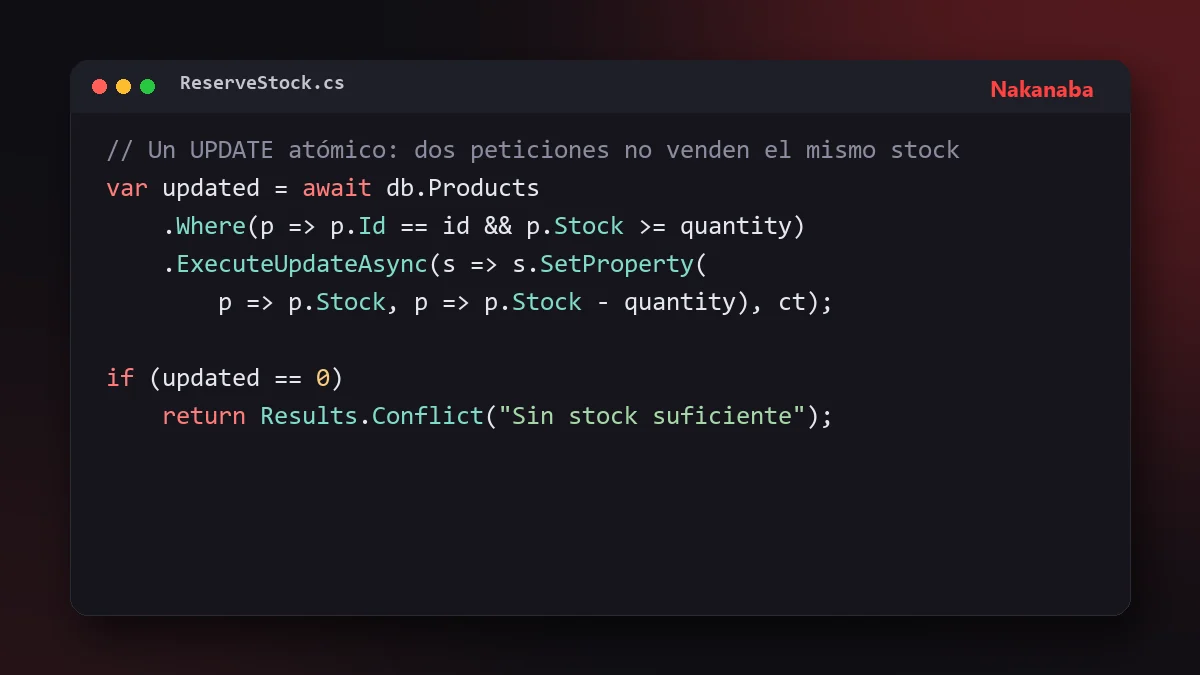
Opción A: la condición dentro de la escritura
var updated = await db.Products
    .Where(p => p.Id == id && p.Stock >= quantity)
    .ExecuteUpdateAsync(s => s.SetProperty(p => p.Stock, p => p.Stock - quantity), ct);

if (updated == 0) return Results.Conflict("Sin stock suficiente");
Un solo UPDATE atómico: SQL Server garantiza que dos peticiones no puedan descontar el mismo stock. Es la opción más simple y la que mejor escala.
Opción B: concurrencia optimista
Cuando la operación necesita la entidad completa y sus reglas:
modelBuilder.Entity<Product>().Property(p => p.RowVersion).IsRowVersion();

try
{
    product.Reserve(quantity); // regla de negocio en la entidad
    await db.SaveChangesAsync(ct);
}
catch (DbUpdateConcurrencyException)
{
    // Otra petición modificó el producto: recargar y reintentar, o informar al usuario
    return Results.Conflict("El producto cambió, intenta de nuevo");
}
EF Core agrega WHERE RowVersion = @original al UPDATE. Si otra petición cambió la fila, no se actualiza nada y se lanza la excepción. No hay bloqueos mientras el usuario piensa, pero bajo mucha contención sobre la misma fila, los reintentos se multiplican.
Opción C: bloqueo pesimista
SELECT ... WITH (UPDLOCK, ROWLOCK) dentro de una transacción bloquea la fila hasta terminar. Es correcto, pero serializa todas las peticiones sobre esa fila. Útil para operaciones cortas y críticas; peligroso si la transacción hace algo lento.
5. Idempotencia para los reintentos
Con alta concurrencia hay más timeouts, y los clientes reintentan. Un POST /api/orders que se reintenta puede crear dos pedidos. Una clave de idempotencia (lo vimos en cómo diseñar una API REST mantenible) convierte el reintento en una operación segura.
6. Mueve lo que no es urgente fuera de la petición
Si confirmar un pedido implica generar la factura, enviar un correo y notificar a la bodega, solo lo primero tiene que ocurrir antes de responder. Lo demás puede ir a una cola. Menos trabajo por petición significa menos tiempo con recursos ocupados y más peticiones atendidas con la misma capacidad.
7. Tiempos límite en todo
Una dependencia lenta, sin tiempo límite, acumula peticiones esperando. Cada una retiene un hilo, una conexión y memoria. Bajo carga, eso tumba la API completa:
builder.Services.AddHttpClient<ShippingClient>()
    .AddStandardResilienceHandler(); // Microsoft.Extensions.Http.Resilience: timeout, reintentos y circuit breaker
El circuit breaker deja de llamar a una dependencia que está fallando, en lugar de seguir esperándola con cada petición.
El trade-off
Cada una de estas decisiones agrega algo: tokens de concurrencia que manejar, colas que operar, claves de idempotencia que guardar, políticas de resiliencia que configurar. En una API con poco tráfico, son complejidad sin beneficio visible. Pero algunas, como las validaciones atómicas, cuestan lo mismo desde el principio y evitan errores de datos que son muy difíciles de corregir después.
Cuándo no hace falta tanto
Una herramienta interna con 30 usuarios no necesita circuit breakers ni colas. Pero sí conviene que las operaciones que modifican cantidades (stock, saldos, cupos) sean atómicas desde el principio: incluso con pocos usuarios, dos clics rápidos en el mismo botón son concurrencia.
Conclusión
Escalar una API es en parte un problema de capacidad (sin estado, asíncrono, conexiones cortas) y en parte un problema de corrección (escrituras atómicas, concurrencia optimista, idempotencia). Lo primero se nota como lentitud; lo segundo, como datos incorrectos. Conviene resolver los dos antes de que una venta especial lo haga por ti.


¿Necesitas un equipo .NET para tu proyecto?
Construimos y modernizamos backends en .NET y SQL Server: APIs, integraciones y sistemas empresariales a medida.
Ver desarrollo a medida