Health Checks en .NET: liveness, readiness y errores comunes
Un health check que siempre responde 200 no sirve, y uno que revisa todo puede tumbar la aplicación. Cómo diseñar health checks útiles en ASP.NET Core.
El balanceador marca la aplicación como sana. El endpoint /health responde 200 en 2 ms. Mientras tanto, todas las peticiones reales fallan porque la base de datos no está disponible.
O el caso contrario: la base de datos tiene un momento de lentitud, el health check que la consulta tarda más de lo permitido, el orquestador reinicia todas las instancias al mismo tiempo y una lentitud de 20 segundos se convierte en una caída de 5 minutos.
Un health check es una pregunta que hace otro sistema. Para diseñarlo bien, hay que saber quién pregunta y qué va a hacer con la respuesta.
Dos preguntas distintas: liveness y readiness
- Liveness: ¿el proceso está vivo o hay que reiniciarlo? Si responde que no, el orquestador mata la instancia y crea otra. Solo debería fallar si la aplicación está en un estado del que no puede recuperarse sola.
- Readiness: ¿puede recibir tráfico ahora? Si responde que no, el balanceador deja de enviarle peticiones, pero no la reinicia. Es la que debe revisar dependencias.
Mezclarlas es el origen de la mayoría de problemas: si el liveness revisa la base de datos, una caída de la base provoca reinicios en cadena que no arreglan nada.
Implementación en ASP.NET Core
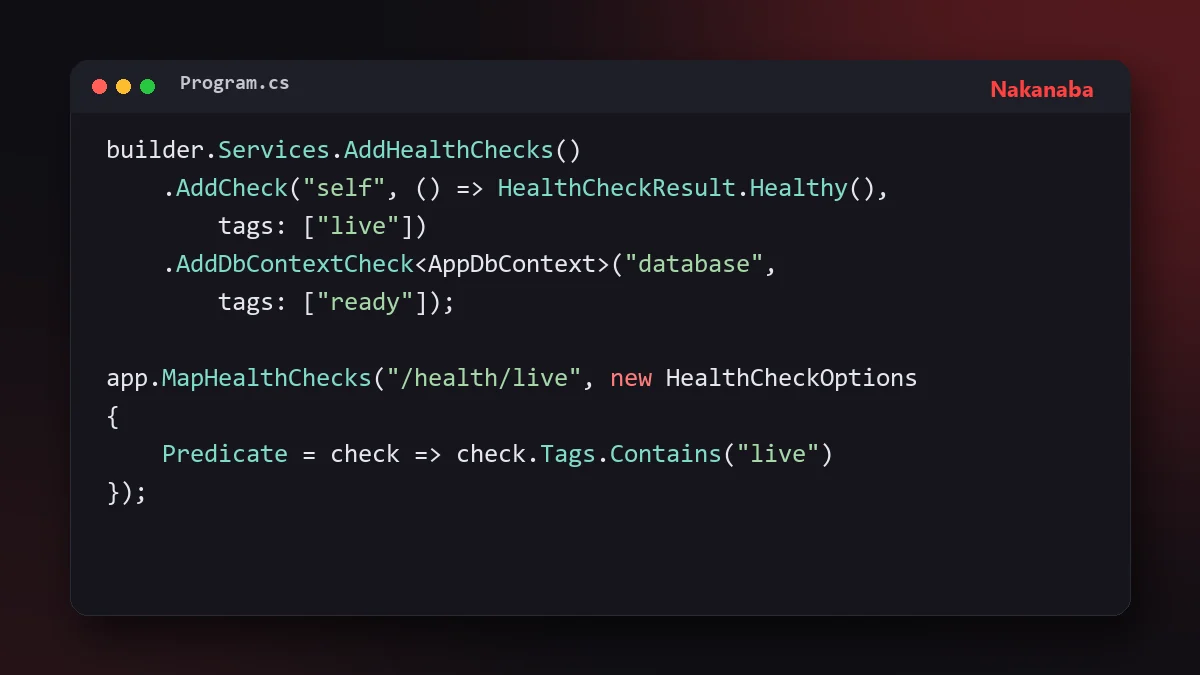
builder.Services.AddHealthChecks()
    // Liveness: solo comprueba que el proceso responde
    .AddCheck("self", () => HealthCheckResult.Healthy(), tags: ["live"])
    // Readiness: dependencias que impiden atender peticiones
    .AddDbContextCheck<AppDbContext>("database", tags: ["ready"])
    .AddCheck<PaymentsGatewayHealthCheck>("payments", tags: ["ready"], failureStatus: HealthStatus.Degraded);

var app = builder.Build();

app.MapHealthChecks("/health/live", new HealthCheckOptions
{
    Predicate = check => check.Tags.Contains("live")
});

app.MapHealthChecks("/health/ready", new HealthCheckOptions
{
    Predicate = check => check.Tags.Contains("ready")
});
AddDbContextCheck viene en el paquete Microsoft.Extensions.Diagnostics.HealthChecks.EntityFrameworkCore. Para otras dependencias (Redis, colas, SQL Server con una consulta propia) existe la colección de la comunidad AspNetCore.HealthChecks.*.
Un health check propio
public sealed class PaymentsGatewayHealthCheck(HttpClient http) : IHealthCheck
{
    public async Task<HealthCheckResult> CheckHealthAsync(HealthCheckContext context, CancellationToken ct = default)
    {
        try
        {
            using var cts = CancellationTokenSource.CreateLinkedTokenSource(ct);
            cts.CancelAfter(TimeSpan.FromSeconds(2)); // nunca esperar más que el sondeo

            var response = await http.GetAsync("status", cts.Token);
            return response.IsSuccessStatusCode
                ? HealthCheckResult.Healthy()
                : HealthCheckResult.Degraded($"La pasarela respondió {(int)response.StatusCode}");
        }
        catch (Exception ex)
        {
            return HealthCheckResult.Degraded("La pasarela de pagos no responde", ex);
        }
    }
}
Tres decisiones en este código:
- Un tiempo límite propio, más corto que el del sondeo. Un health check que se cuelga es peor que uno que falla.
Degradeden lugar deUnhealthy. Si la pasarela de pagos cae, la aplicación todavía puede mostrar el catálogo y tomar pedidos. Sacarla del balanceador por eso sería convertir una falla parcial en una total.- Sin lanzar excepciones: el resultado describe el estado.
Cuidado con lo que revisas en readiness
Revisar una dependencia en readiness significa: si esta dependencia falla, esta instancia no debe recibir tráfico. Funciona si el problema es de esa instancia (por ejemplo, no puede alcanzar la base de datos por un problema de red local). Pero si la dependencia cae para todas las instancias, todas se marcan como no listas a la vez y el balanceador se queda sin destinos.
Por eso conviene revisar en readiness solo las dependencias sin las cuales la aplicación no puede hacer nada útil, y marcar el resto como Degraded.
No consultes la base de datos en cada sondeo
Un orquestador puede consultar el health check cada pocos segundos, desde varios nodos. Con 20 instancias, eso son muchas consultas a la base de datos solo para preguntar si está bien. Algunas opciones:
- Consultas triviales (
SELECT 1), nunca consultas de negocio. - Guardar el resultado en caché unos segundos.
- Un intervalo de sondeo razonable en el orquestador (10-30 segundos para readiness).
Respuesta con detalle, pero no pública
Por defecto, el endpoint responde solo Healthy, Degraded o Unhealthy. Para diagnóstico, puedes escribir el detalle de cada revisión:
app.MapHealthChecks("/health/ready", new HealthCheckOptions
{
    Predicate = check => check.Tags.Contains("ready"),
    ResponseWriter = async (context, report) =>
    {
        context.Response.ContentType = "application/json";
        await context.Response.WriteAsJsonAsync(new
        {
            status = report.Status.ToString(),
            checks = report.Entries.Select(e => new { e.Key, status = e.Value.Status.ToString(), e.Value.Duration })
        });
    }
}).RequireHost("*:8081"); // solo en el puerto interno
Ese detalle (nombres de dependencias, tiempos) no debería ser accesible desde internet: describe la arquitectura interna a cualquiera que lo consulte. Un puerto interno, RequireHost o RequireAuthorization resuelven eso.
Startup: el tercer tipo
Si la aplicación tarda en arrancar (carga cachés, ejecuta migraciones), un liveness muy estricto puede matarla antes de que termine. Kubernetes tiene un sondeo de startup para esto: mientras no pase, no se evalúan los otros dos. En ASP.NET Core se implementa igual, con otra etiqueta.
El trade-off
Cuanto más revisa un health check, más fiel es su respuesta y más formas tiene de causar problemas: carga extra, falsos positivos, reinicios en cadena. Un health check demasiado simple miente; uno demasiado completo puede convertirse en la causa de la caída.
Cuándo no hace falta tanta separación
Una aplicación que corre en un solo servidor, sin orquestador ni balanceador, no tiene a nadie que reaccione a liveness o readiness. Ahí un único /health para el monitoreo externo es suficiente. La separación cobra sentido cuando hay algo que reinicia instancias o reparte tráfico según la respuesta.
Conclusión
Liveness pregunta si hay que reiniciar; readiness, si se puede atender. Mantén el primero trivial, el segundo enfocado en lo indispensable, y usa Degraded para lo que no lo es. Y no expongas el detalle al público. Los health checks complementan lo que ya vimos sobre qué registrar en los logs: unos dicen si algo funciona, los otros explican por qué no.


¿Necesitas un equipo .NET para tu proyecto?
Construimos y modernizamos backends en .NET y SQL Server: APIs, integraciones y sistemas empresariales a medida.
Ver desarrollo a medida