Aspire en .NET: qué resuelve y cuándo no lo necesitas
Aspire ordena el arranque local de varios servicios, sus conexiones y su telemetría. Qué hace el AppHost, qué no hace y en qué proyectos sobra.
Un desarrollador nuevo clona el repositorio. Para levantar el sistema necesita SQL Server, Redis, la API, un worker y el frontend. El README tiene veinte pasos, dos ya no funcionan, y las cadenas de conexión están repartidas entre appsettings.Development.json, user secrets y un docker-compose.yml que alguien dejó de mantener hace meses.
Dos días después logra ejecutar todo. Cuando algo falla entre la API y el worker, tiene los logs en tres terminales distintas y ninguna traza que una las piezas.
Ese es el problema que ataca Aspire: no la arquitectura del sistema, sino el costo de ejecutarlo y observarlo completo en la máquina de cada desarrollador.
Qué es, sin el marketing
Aspire tiene tres piezas, y conviene separarlas porque se pueden adoptar por partes:
- AppHost: un proyecto de C# donde se declara qué compone el sistema (proyectos, contenedores, bases de datos) y cómo se conectan.
- Integraciones: paquetes NuGet que registran un cliente (SQL Server, Redis, colas) ya configurado con health checks, reintentos y telemetría.
- Dashboard: una interfaz local que muestra logs, trazas y métricas de todos los recursos, basada en OpenTelemetry.
El nombre cambió con el tiempo: empezó como ".NET Aspire" y desde la versión 13 se llama solo "Aspire", porque el AppHost ya puede orquestar servicios en otros lenguajes.
El AppHost: el sistema descrito en código
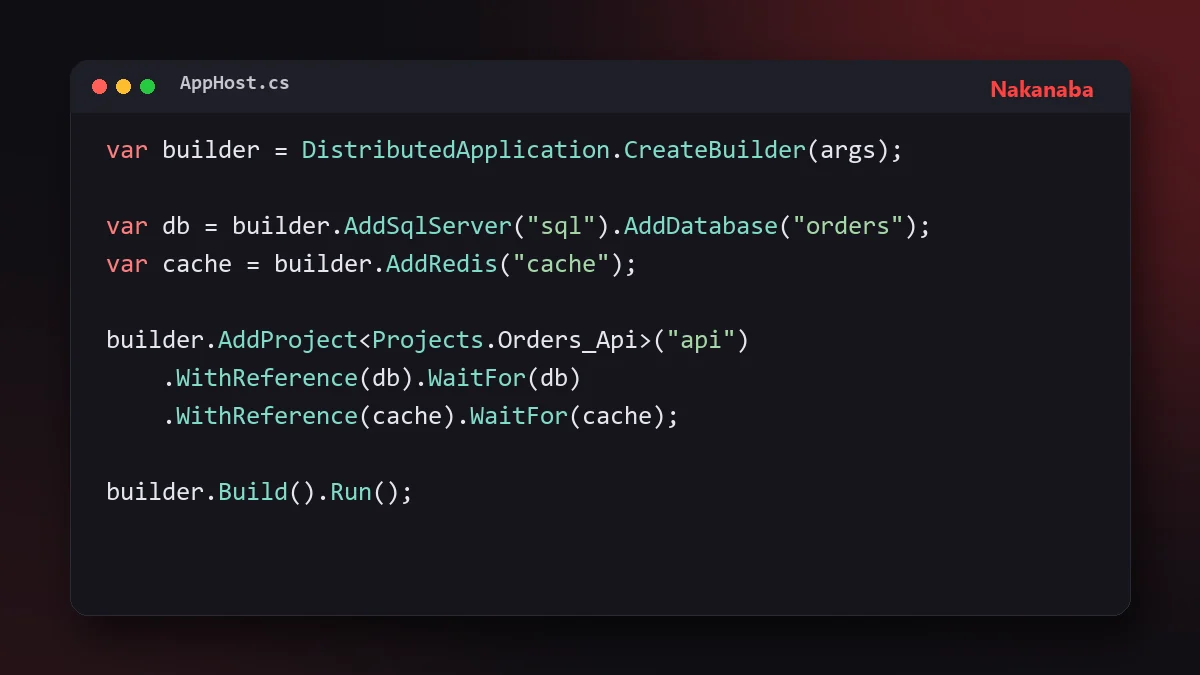
var builder = DistributedApplication.CreateBuilder(args);

var db = builder.AddSqlServer("sql")
    .WithDataVolume()
    .AddDatabase("orders");

var cache = builder.AddRedis("cache");

builder.AddProject<Projects.Orders_Api>("api")
    .WithReference(db).WaitFor(db)
    .WithReference(cache).WaitFor(cache);

builder.AddProject<Projects.Orders_Worker>("worker")
    .WithReference(db).WaitFor(db);

builder.Build().Run();
Al ejecutar este proyecto, Aspire levanta SQL Server y Redis como contenedores, inicia la API y el worker, y le entrega a cada uno lo que necesita. Tres detalles explican por qué es más que un docker-compose escrito en C#:
WithReferenceinyecta la conexión. La API recibeConnectionStrings__orderscomo variable de entorno. No hay cadena de conexión escrita en ningún archivo de desarrollo, ni puertos fijos que choquen entre proyectos.WaitForordena el arranque. La API no inicia hasta que la base de datos responde, lo que elimina los reintentos manuales del primer minuto.- Los proyectos .NET corren como procesos normales, no dentro de contenedores, así que la depuración y el hot reload funcionan como siempre.
Del lado del servicio
La API no necesita saber que Aspire existe; solo lee una cadena de conexión con el nombre acordado. Las integraciones hacen ese registro más corto:
var builder = WebApplication.CreateBuilder(args);

builder.AddServiceDefaults();                         // telemetría, health checks, resiliencia
builder.AddSqlServerDbContext<AppDbContext>("orders"); // usa ConnectionStrings:orders
builder.AddRedisDistributedCache("cache");

var app = builder.Build();
app.MapDefaultEndpoints();                            // /health y /alive
AddServiceDefaults viene de un proyecto compartido que la plantilla genera dentro de tu solución (ServiceDefaults). No es una caja negra: es código tuyo, con la configuración de OpenTelemetry, los health checks y la resiliencia de HttpClient, y se puede leer y modificar.
En producción, la misma API toma ConnectionStrings:orders de donde la configures: variables de entorno, Key Vault o el mecanismo que ya uses. Ese es el punto que más confusión genera: el AppHost no se despliega ni corre en producción. Es una herramienta de desarrollo y, opcionalmente, una fuente para generar artefactos de despliegue.
El dashboard: la razón por la que muchos se quedan
Con los servicios emitiendo OpenTelemetry, el dashboard muestra en una sola pantalla:
- Los logs estructurados de todos los recursos, filtrables por servicio y nivel.
- Las trazas distribuidas: una petición que entra a la API, consulta SQL Server, publica un mensaje y termina en el worker aparece como una sola línea de tiempo.
- Métricas básicas del runtime y de las peticiones HTTP.
Para depurar un flujo que cruza dos procesos, ver la traza completa ahorra más tiempo que cualquier cantidad de mensajes en consola. Qué conviene registrar en esos logs sigue siendo decisión tuya; lo cubrimos en qué registrar y qué no.
Los trade-offs
Un proyecto más y una dependencia más. El AppHost y ServiceDefaults son código que hay que mantener y actualizar. Aspire ha evolucionado rápido entre versiones, con cambios en nombres de paquetes y de API, y eso se paga en cada actualización.
Requiere un motor de contenedores. Cada desarrollador necesita Docker o Podman funcionando. En equipos con máquinas restringidas o licencias pendientes, ese requisito puede ser el obstáculo real.
El despliegue es la parte menos resuelta. Aspire puede generar artefactos para Docker Compose, Kubernetes o Azure a partir del AppHost. Funciona bien cuando el destino coincide con lo que la herramienta espera. Si ya tienes un pipeline y una infraestructura definidos, lo más sensato suele ser dejar el despliegue como está y usar Aspire solo en desarrollo.
No reemplaza la observabilidad de producción. El dashboard es para el ciclo local. En producción la telemetría va al backend que elijas (Application Insights, Grafana u otro); lo que Aspire aporta ahí es que los servicios ya emiten OpenTelemetry bien configurado.
No decide la arquitectura. Que levantar cinco servicios sea fácil no significa que el sistema necesite cinco servicios. Esa decisión es anterior y tiene sus propios costos, como vimos en monolito modular vs microservicios.
Cuándo usarlo
- El sistema tiene varios procesos que deben correr juntos: API, worker, frontend, más de una base de datos o un broker.
- Poner en marcha a una persona nueva toma más de una mañana.
- Diagnosticas con frecuencia problemas que cruzan servicios y no tienes trazas distribuidas en local.
- Quieres estandarizar OpenTelemetry y health checks sin copiar la misma configuración en cada proyecto.
Cuándo no lo necesitas
- Una API y una base de datos.
dotnet runy una cadena de conexión siguen siendo más simples que un AppHost. Aspire no aporta mucho cuando no hay nada que orquestar. - El equipo no puede usar contenedores en sus máquinas.
- Ya tienes un
docker-composeque funciona y se mantiene. Migrarlo solo por estar al día no cambia nada para el usuario del sistema. - Buscas una plataforma de despliegue. Aspire no es un orquestador de producción ni sustituye a Kubernetes o a un servicio administrado.
Hay un punto intermedio que vale la pena conocer: adoptar solo ServiceDefaults y OpenTelemetry, sin AppHost. Se obtiene la telemetría estandarizada sin cambiar la forma de ejecutar el proyecto.
Conclusión
Aspire resuelve bien un problema concreto: que un sistema de varias piezas arranque con un comando y se pueda observar completo mientras se desarrolla. No es un requisito para construir sistemas distribuidos, y en una aplicación de un solo proceso agrega más de lo que quita. La pregunta para decidir es cuánto tiempo pierde hoy el equipo levantando el entorno y diagnosticando entre servicios; si la respuesta es "poco", puede esperar.


Lleva tu aplicación a la nube con criterio
Diseñamos arquitecturas en Azure que crecen con tu negocio sin disparar los costos de infraestructura.
Ver soluciones escalables