Cómo mejorar el rendimiento de una API .NET
Antes de cambiar código, mide. Una guía en orden: dónde se va el tiempo en una API ASP.NET Core, qué revisar primero y qué optimizaciones valen la pena.
"La API está lenta" puede significar cien cosas distintas. Una consulta sin índice, un pool de hilos agotado, una dependencia externa que tarda tres segundos, una respuesta de 4 MB o un N+1 escondido en un servicio. Cada una se corrige de forma diferente, y optimizar la equivocada no cambia nada.
La forma más efectiva de mejorar el rendimiento de una API no empieza en el código. Empieza en medir dónde se va el tiempo.
Paso 1: medir antes de cambiar
Sin datos, la optimización es una apuesta. Lo mínimo que necesitas es saber, por endpoint:
- Cuántas peticiones recibe.
- Su latencia en percentiles (p50, p95, p99), no solo el promedio.
- En qué se va el tiempo: código propio, base de datos, llamadas externas.
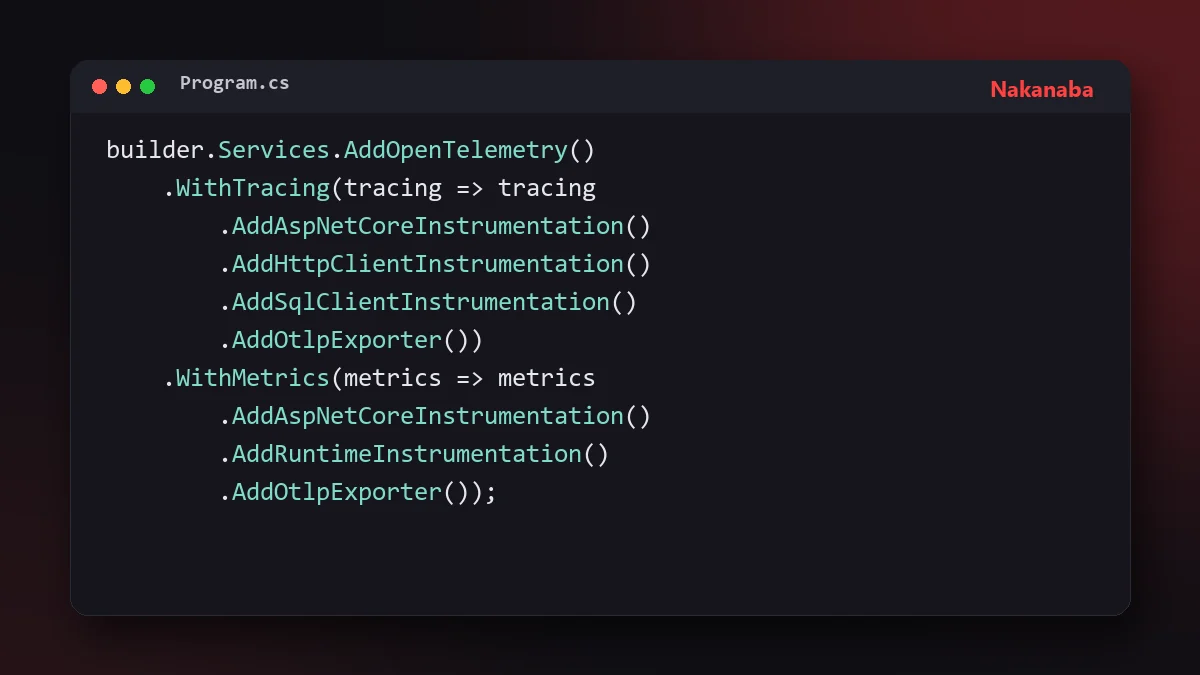
OpenTelemetry da todo eso con poca configuración:
builder.Services.AddOpenTelemetry()
    .WithTracing(tracing => tracing
        .AddAspNetCoreInstrumentation()
        .AddHttpClientInstrumentation()
        .AddSqlClientInstrumentation()
        .AddOtlpExporter())
    .WithMetrics(metrics => metrics
        .AddAspNetCoreInstrumentation()
        .AddRuntimeInstrumentation()
        .AddOtlpExporter());
Con esto, cada petición tiene una traza que muestra cuánto tardó cada consulta SQL y cada llamada HTTP. En Azure, Application Insights recibe lo mismo.
Mira el p95 y el p99, no el promedio. Un endpoint con promedio de 120 ms puede tener un p99 de 4 segundos: uno de cada cien usuarios espera mucho, y suele ser el que más datos tiene.
Paso 2: ataca primero la base de datos
En la mayoría de APIs de negocio, la mayor parte del tiempo de una petición se pasa esperando a la base de datos. Por eso las mejoras más grandes suelen estar ahí:
- Encuentra las consultas que más cuestan en total, no las más lentas individualmente (cómo detectar consultas lentas).
- Busca el N+1: endpoints cuya cantidad de consultas crece con los datos (el problema N+1).
- Proyecta solo lo necesario y filtra en la base de datos (problemas de EF Core en producción).
- Revisa el plan de ejecución de las consultas críticas y sus índices (leer un execution plan).
Una consulta que pasa de 400 ms a 15 ms mejora más un endpoint que cualquier ajuste en el código C#.
Paso 3: no bloquees hilos
Si la API se vuelve lenta con carga pero la CPU está baja, sospecha del thread pool: .Result, .Wait() o I/O síncrono bloquean hilos y el pool se queda sin capacidad. Revisa los errores comunes con async/await.
Una forma de confirmarlo en producción:
dotnet-counters monitor --process-id <pid> --counters System.Runtime
Si ThreadPool Queue Length crece y ThreadPool Thread Count sube despacio mientras la CPU está baja, hay hilos bloqueados.
Paso 4: reduce el trabajo por petición
- Paraleliza llamadas independientes con
Task.WhenAll(sin compartir el mismoDbContext). - Mueve a segundo plano lo que no necesita terminar antes de responder: correos, notificaciones, facturas.
- Cachea lo que se lee mucho y cambia poco, sabiendo qué pasa si está desactualizado (MemoryCache vs caché distribuida).
- Pagina las listas: una respuesta de 10.000 elementos es lenta de consultar, serializar, transmitir y renderizar.
Paso 5: dependencias externas con límites
Una API externa que tarda 3 segundos hace que tu endpoint tarde 3 segundos. Con carga, esas esperas se acumulan y consumen recursos:
builder.Services.AddHttpClient<ShippingClient>(c => c.BaseAddress = new Uri("https://api.transportadora.example/"))
    .AddStandardResilienceHandler(options =>
    {
        options.AttemptTimeout.Timeout = TimeSpan.FromSeconds(2);
        options.TotalRequestTimeout.Timeout = TimeSpan.FromSeconds(5);
    });
Tiempos límite, reintentos con espera y circuit breaker evitan que una dependencia lenta arrastre a toda la API.
Paso 6: la respuesta HTTP
Cuando lo anterior está resuelto, la respuesta misma puede pesar:
builder.Services.AddResponseCompression(options => options.EnableForHttps = true);
app.UseResponseCompression();
- Compresión para respuestas JSON grandes (si no la hace ya el proxy o el CDN).
- DTOs con solo los campos necesarios, no entidades completas (DTOs en la API).
- Caché HTTP (
Cache-Control,ETag) para recursos que cambian poco y se piden mucho.
Un detalle sobre EnableForHttps: comprimir respuestas cifradas que mezclan secretos con datos controlados por el usuario puede exponer la aplicación a ataques como BREACH. Para APIs JSON típicas el riesgo es bajo, pero conviene conocerlo.
Paso 7: las micro-optimizaciones, al final
Span<T>, pooling de objetos, serialización con source generators de System.Text.Json, consultas compiladas de EF Core. Son herramientas reales y en rutas con mucho tráfico se notan. Pero ahorran microsegundos, y casi siempre hay milisegundos esperando en los pasos anteriores.
Si llegas a este punto, usa BenchmarkDotNet para medir el cambio en aislamiento, y verifica en producción que la mejora se refleja en los percentiles.
Paso 8: mantenerlo
El rendimiento se degrada con el tiempo: los datos crecen, se agregan funcionalidades y las consultas que eran rápidas dejan de serlo. Algunas prácticas que ayudan:
- Alertas sobre el p95 de los endpoints críticos, no solo sobre errores.
- Pruebas de carga antes de eventos conocidos (temporadas, campañas, lanzamientos).
- Revisión periódica de las consultas más costosas en Query Store.
El trade-off
Cada optimización tiene un costo: complejidad, código menos directo, más infraestructura o datos que pueden estar desactualizados. Por eso el orden importa. Los primeros pasos (medir, base de datos, async) suelen dar la mayor mejora con el menor costo. Los últimos dan mejoras pequeñas con un costo de mantenimiento mayor.
Cuándo parar
Cuando los percentiles cumplen el objetivo que importa al negocio. Si el p95 del endpoint de checkout está en 180 ms y el objetivo era 300, seguir optimizando ese endpoint tiene poco retorno. Hay que definir ese objetivo antes de empezar, no después.
Conclusión
Mejorar el rendimiento de una API es un proceso en orden: medir, encontrar dónde se va el tiempo, corregir lo que más pesa y volver a medir. La mayoría de las veces, la respuesta está en la base de datos, en un hilo bloqueado o en una dependencia sin límite de tiempo, mucho antes de llegar a las micro-optimizaciones.


¿Necesitas un equipo .NET para tu proyecto?
Construimos y modernizamos backends en .NET y SQL Server: APIs, integraciones y sistemas empresariales a medida.
Ver desarrollo a medida