Execution plans en SQL Server: cómo empezar a leerlos
El plan de ejecución dice por qué una consulta es lenta si sabes dónde mirar: qué operadores revisar primero, qué advertencias importan y cuáles ignorar.
La primera vez que se abre un plan de ejecución, parece un diagrama de cuarenta cajas con flechas de distintos grosores y porcentajes que no suman lo que uno espera. Es fácil cerrarlo y volver a probar índices al azar.
No hace falta entender cada operador para sacarle provecho. Con cinco o seis cosas que revisar en orden, el plan responde la pregunta que importa: dónde se va el tiempo y por qué.
Estimado o real
SQL Server ofrece dos versiones del plan:
- Plan estimado (
Ctrl+Len SSMS): lo que el optimizador piensa hacer, sin ejecutar la consulta. - Plan real (
Ctrl+My luego ejecutar): lo que hizo, con las filas que realmente pasaron por cada operador.
Para diagnosticar, casi siempre quieres el real. La diferencia entre lo estimado y lo real es una de las pistas más valiosas del plan.
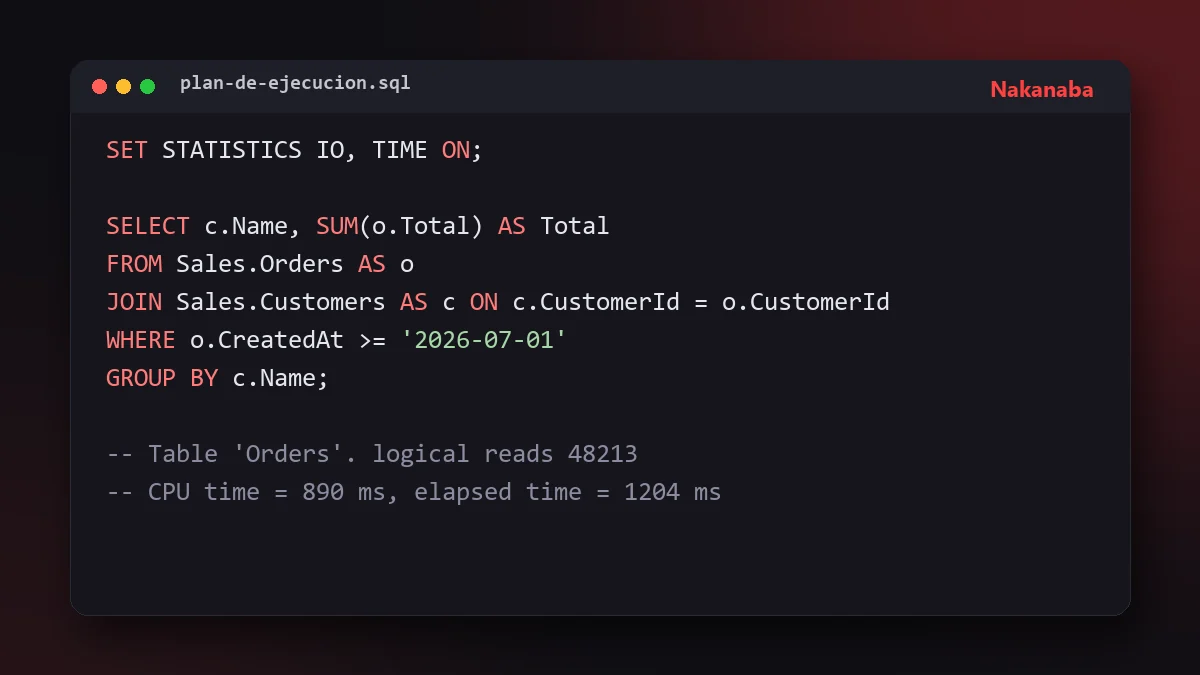
Junto con el plan, activa las estadísticas de lectura y tiempo:
SET STATISTICS IO, TIME ON;

SELECT c.Name, SUM(o.Total) AS Total
FROM Sales.Orders AS o
JOIN Sales.Customers AS c ON c.CustomerId = o.CustomerId
WHERE o.CreatedAt >= '2026-07-01'
GROUP BY c.Name;
En la pestaña Messages aparece algo así:
Table 'Orders'. Scan count 1, logical reads 48213, ...
Table 'Customers'. Scan count 0, logical reads 1840, ...
 SQL Server Execution Times: CPU time = 890 ms, elapsed time = 1204 ms.
Las lecturas lógicas (páginas de 8 KB leídas desde memoria) son la métrica más estable para comparar antes y después de un cambio. El tiempo varía según la carga del servidor; las lecturas no.
Cómo se lee: de derecha a izquierda
Los datos fluyen de derecha a izquierda. Los operadores de la derecha leen las tablas; los de la izquierda combinan, agregan y entregan el resultado. El grosor de las flechas indica cuántas filas pasan.
Primera revisión: busca las flechas gruesas. Si una flecha lleva 2 millones de filas hacia un operador que termina devolviendo 20, ahí se está haciendo trabajo de más.
Los operadores que más importan
| Operador | Qué significa | Cuándo preocuparse |
|---|---|---|
| Index Seek | Va directo a las filas que necesita | Casi nunca |
| Index Scan / Clustered Index Scan | Recorre el índice o la tabla completa | En tablas grandes, cuando esperabas pocas filas |
| Key Lookup | Va a la tabla por columnas que faltan en el índice | Cuando se ejecuta miles de veces |
| Nested Loops | Por cada fila de arriba, busca en la de abajo | Con muchas filas en la entrada superior |
| Hash Match | Construye una tabla hash en memoria | Si derrama a tempdb |
| Sort | Ordena en memoria | Si derrama a tempdb o procesa millones de filas |
Un scan no es malo por definición. En una tabla de 500 filas, o cuando la consulta realmente necesita casi toda la tabla, es la opción más eficiente. Es un problema cuando aparece donde debería haber pocas filas.
Estimadas contra reales
Pasa el cursor sobre un operador y compara:
- Estimated Number of Rows: 12
- Actual Number of Rows: 380.000
Cuando la diferencia es de órdenes de magnitud, el optimizador eligió el plan con información equivocada. Eligió Nested Loops pensando en 12 filas y le tocaron 380.000. Las causas habituales:
- Estadísticas desactualizadas en una tabla que creció mucho.
- Predicados que el optimizador no puede estimar: funciones sobre columnas, variables locales en lugar de parámetros, tablas variables.
- Parameter sniffing: el plan se compiló con un valor muy distinto al actual.
Corregir la estimación suele arreglar el plan completo, sin tocar índices.
Las advertencias que sí importan
Un triángulo amarillo sobre un operador es una advertencia. Las más útiles:
CONVERT_IMPLICIT: un tipo de dato no coincide (por ejemplonvarcharcontra una columnavarchar). Puede impedir un seek.- Spill to tempdb: un Sort o Hash Match no tuvo memoria suficiente y escribió en disco. Suele venir de una estimación de filas muy baja.
- No join predicate: un
JOINsin condición. Casi siempre es un error en la consulta.
El costo en porcentaje: úsalo con cuidado
Cada operador muestra un porcentaje del costo total. Ese porcentaje es estimado, incluso en el plan real. Si las estimaciones están mal, los porcentajes también. Un operador con "2 %" puede ser el que realmente consume el tiempo.
Por eso, en lugar de ir directo al porcentaje más alto, empieza por las flechas gruesas y por las diferencias entre estimadas y reales.
Y el "missing index" verde
A veces el plan muestra en verde: Missing Index (Impact 94%). Es una pista útil, pero:
- No sabe qué otros índices tienes; puede sugerir uno casi idéntico a uno existente.
- No considera el costo que el índice agregará a las escrituras.
- Sugiere las columnas en un orden que no siempre es el mejor.
Tómalo como punto de partida y revísalo contra los índices que ya tiene la tabla (lo vimos en índices en SQL Server).
Un orden práctico de revisión
- Ejecuta con el plan real y
STATISTICS IO. - Identifica la tabla con más lecturas lógicas.
- En el plan, busca la flecha más gruesa que sale de esa tabla.
- Compara estimadas contra reales en ese operador.
- Revisa las advertencias.
- Solo entonces piensa en índices o en reescribir la consulta.
El trade-off de optimizar con el plan
El plan de una ejecución describe esa ejecución, con esos parámetros. Una consulta afinada para un cliente con 10 pedidos puede empeorar para uno con 100.000. Prueba los cambios con valores representativos de los extremos, no solo con el que te reportaron.
Cuándo no hace falta abrir el plan
Si sys.dm_exec_requests muestra que la consulta está bloqueada por otra sesión, el plan no te va a decir nada útil: la consulta no está trabajando, está esperando. Revisa primero si está trabajando o esperando, como explicamos en por qué una consulta SQL puede ser lenta.
Conclusión
No necesitas conocer los más de cien operadores que existen. Lecturas lógicas, flechas gruesas, estimadas contra reales y advertencias: con eso se resuelve la mayoría de los casos. El resto se aprende cuando aparece.


¿Tu base de datos se volvió lenta?
Revisamos consultas, índices y modelo de datos para que tu sistema responda rápido aunque los datos sigan creciendo.
Ver desarrollo a medida