Índices en SQL Server: clustered y nonclustered con ejemplos
Qué cambia entre un índice clustered y uno nonclustered, cómo elegir columnas e INCLUDE con ejemplos, y por qué más índices no siempre aceleran la aplicación.
Un índice es la herramienta más efectiva para acelerar una consulta y, al mismo tiempo, la que más se usa sin pensar. Es fácil terminar con una tabla de pedidos con doce índices, la mitad sin uso y la otra mitad casi idénticos, mientras las escrituras se vuelven cada vez más lentas.
Para elegir bien hay que entender qué guarda cada tipo de índice y cómo los recorre SQL Server.
Clustered: la tabla misma, ordenada
Un índice clustered no es una estructura aparte: es la tabla, guardada en el orden de la clave del índice. Por eso solo puede haber uno por tabla.
Por defecto, la clave primaria crea el índice clustered. En la mayoría de tablas transaccionales eso está bien, siempre que la clave sea:
- Estrecha: se copia en todos los demás índices, así que una clave de 4 u 8 bytes es mucho mejor que una de 50.
- Única: si no lo es, SQL Server agrega un valor interno para desempatar.
- Creciente: las filas nuevas van al final y no hay que reorganizar páginas en medio de la tabla.
- Estable: cambiar la clave de una fila implica moverla físicamente.
Un int o bigint con IDENTITY cumple las cuatro. Un GUID aleatorio falla en dos, y por eso merece su propio artículo.
Nonclustered: una copia ordenada con un puntero
Un índice nonclustered es una estructura separada con las columnas de la clave, ordenadas, y un puntero a la fila completa. Ese puntero es la clave del índice clustered.
CREATE NONCLUSTERED INDEX IX_Orders_CustomerId
    ON Sales.Orders (CustomerId);
Con esta consulta:
SELECT OrderId, CreatedAt, Total
FROM Sales.Orders
WHERE CustomerId = 42;
SQL Server busca en IX_Orders_CustomerId las filas del cliente 42 (un Index Seek), y luego, por cada una, va al índice clustered a buscar CreatedAt y Total, que no están en el índice. Esa segunda búsqueda es un Key Lookup.
Con 15 pedidos es instantáneo. Con 40.000, son 40.000 búsquedas individuales, y en muchos casos el optimizador decide que es más barato recorrer la tabla completa.
INCLUDE: cubrir la consulta sin agrandar la clave
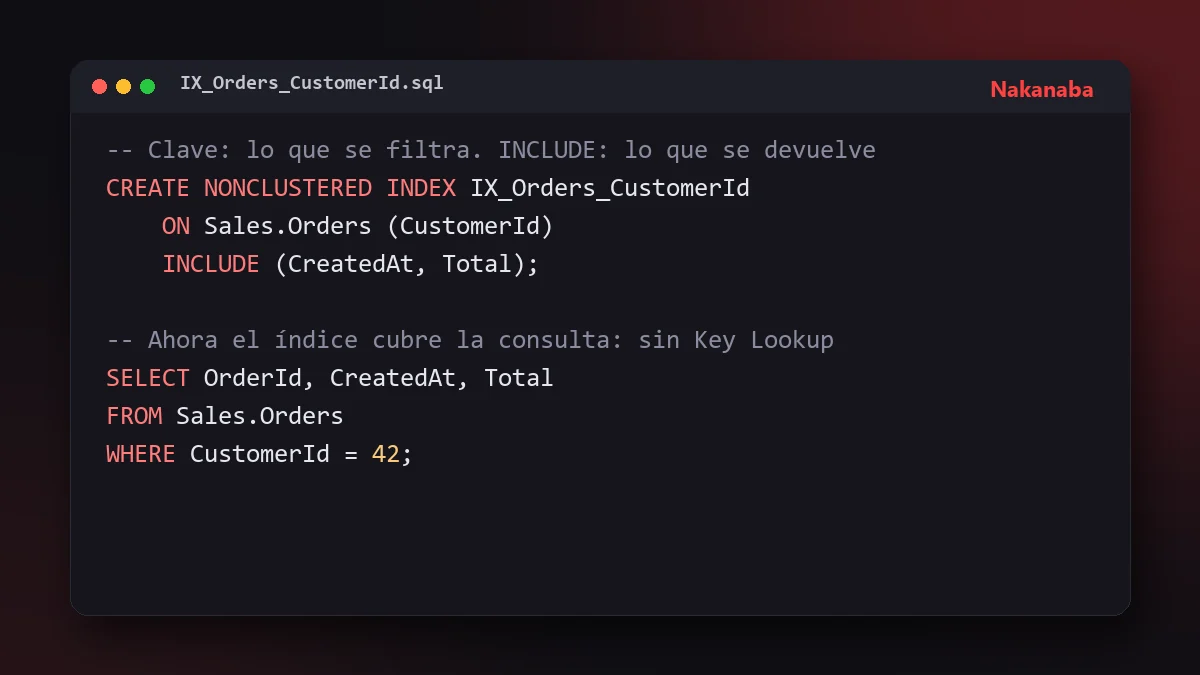
CREATE NONCLUSTERED INDEX IX_Orders_CustomerId
    ON Sales.Orders (CustomerId)
    INCLUDE (CreatedAt, Total);
Ahora el índice cubre la consulta: todo lo que pide está en él y no hay Key Lookup. Las columnas de INCLUDE solo se guardan en el nivel hoja del índice; no forman parte del orden ni de la clave, así que no lo encarecen tanto como agregarlas a la clave.
La regla práctica:
- Clave: columnas por las que filtras (
WHERE), unes (JOIN) u ordenas (ORDER BY). - INCLUDE: columnas que solo se devuelven en el
SELECT.
El orden de las columnas en la clave importa
CREATE INDEX IX_Orders_Customer_Status_Date
    ON Sales.Orders (CustomerId, Status, CreatedAt);
Este índice sirve para:
WHERE CustomerId = @cWHERE CustomerId = @c AND Status = @sWHERE CustomerId = @c AND Status = @s ORDER BY CreatedAt
Pero no sirve para un seek con WHERE Status = @s sola, porque Status no es la primera columna. Funciona como una guía telefónica ordenada por apellido y luego por nombre: puedes buscar "todos los García", pero no "todos los Juan".
La recomendación habitual es poner primero las columnas de igualdad, después las de rango (>, <, BETWEEN) y al final las de ordenamiento.
Índices filtrados
Si casi todas las consultas buscan un subconjunto pequeño, puedes indexar solo ese subconjunto:
CREATE INDEX IX_Orders_Pending
    ON Sales.Orders (CreatedAt)
    INCLUDE (CustomerId, Total)
    WHERE Status = 'Pending';
En una tabla con millones de pedidos y unos cientos pendientes, este índice es diminuto y muy rápido de mantener. La contrapartida: los parámetros deben coincidir con el filtro para que el optimizador lo use, y no funciona bien con algunas configuraciones de sesión (SET options) que usan ciertas herramientas.
Cómo saber qué índices sobran
SQL Server registra cómo se usa cada índice desde el último reinicio:
SELECT OBJECT_NAME(i.object_id) AS TableName, i.name AS IndexName,
       s.user_seeks, s.user_scans, s.user_lookups, s.user_updates
FROM sys.indexes AS i
LEFT JOIN sys.dm_db_index_usage_stats AS s
    ON s.object_id = i.object_id AND s.index_id = i.index_id
   AND s.database_id = DB_ID()
WHERE OBJECTPROPERTY(i.object_id, 'IsUserTable') = 1
ORDER BY s.user_updates DESC;
Un índice con muchos user_updates y casi ningún seek o scan es puro costo. Antes de borrarlo, verifica que el servidor lleve encendido el tiempo suficiente como para incluir los procesos de fin de mes.
El trade-off
Cada índice nonclustered:
- Acelera las lecturas que lo usan.
- Se actualiza en cada
INSERTyDELETE, y en cadaUPDATEque toque sus columnas. - Ocupa espacio en disco, en memoria y en las copias de seguridad.
En una tabla de solo lectura (un catálogo de reportes), muchos índices son razonables. En una tabla que recibe escrituras constantes, cada índice debe justificarse con una consulta real.
Cuándo no agregar un índice
- Cuando la consulta lenta está bloqueada, no leyendo de más (revisa primero por qué una consulta SQL puede ser lenta).
- Cuando ya existe uno con las mismas columnas iniciales. Muchas veces basta con ampliar el
INCLUDEdel existente. - En tablas pequeñas, de unos pocos miles de filas, donde un scan cuesta casi lo mismo.
- Cuando la sugerencia viene sola del missing index del plan de ejecución. Es útil como pista, pero no considera los índices que ya tienes ni el costo de escritura.
Conclusión
El clustered decide cómo está guardada la tabla; los nonclustered son atajos para consultas concretas. Un buen índice responde a una consulta que existe, cubre lo que esa consulta necesita y no duplica a otro. Lo demás es costo de escritura que alguien terminará pagando.


¿Tu base de datos se volvió lenta?
Revisamos consultas, índices y modelo de datos para que tu sistema responda rápido aunque los datos sigan creciendo.
Ver desarrollo a medida