Normalización vs rendimiento: cuándo desnormalizar
Un modelo normalizado evita inconsistencias; uno desnormalizado responde más rápido. Cuándo duplicar datos en SQL Server y cómo hacerlo con control.
El listado de pedidos necesita, por cada pedido, el nombre del cliente, la ciudad, el total, la cantidad de productos y el último estado. Con un modelo normalizado, eso son cinco tablas unidas y una agregación por fila. Con 2 millones de pedidos, la pantalla tarda.
La tentación es agregar columnas CustomerName, Total y ItemCount a la tabla de pedidos. Puede ser la decisión correcta. También puede convertirse en datos que no cuadran y nadie sabe cuál es el valor verdadero.
Para qué existe la normalización
Normalizar es guardar cada dato una sola vez. Si el nombre del cliente está solo en Customers, cambiarlo es una actualización en un lugar y todos los pedidos lo reflejan.
El objetivo no es la elegancia del modelo: es evitar anomalías de actualización. Si el nombre está copiado en cada pedido, cambiarlo exige actualizar miles de filas, y si alguna falla o alguien se olvida, el sistema muestra dos nombres distintos para el mismo cliente.
Para un sistema transaccional, la tercera forma normal es un buen punto de partida. La pregunta es cuándo apartarse de ella.
Primero: ¿el problema es realmente el modelo?
Antes de duplicar datos, conviene descartar lo más barato. Muchos "el JOIN es lento" son en realidad:
- Un índice que falta en la columna de unión.
- Una consulta que trae todas las columnas en lugar de las necesarias.
- Una agregación que se calcula sobre toda la historia cuando la pantalla muestra el último mes.
SQL Server está diseñado para unir tablas. Un JOIN entre cinco tablas bien indexadas sobre millones de filas puede responder en milisegundos. Revisa el plan de ejecución antes de cambiar el modelo.
Desnormalización con control: tres formas
1. Columnas calculadas persistidas
Si el valor se deriva de otras columnas de la misma fila, SQL Server puede mantenerlo:
ALTER TABLE Sales.OrderLines
ADD LineTotal AS (Quantity * UnitPrice) PERSISTED;

CREATE INDEX IX_OrderLines_LineTotal ON Sales.OrderLines (LineTotal);
El valor se guarda y se puede indexar, pero nunca queda desincronizado: lo mantiene el motor.
2. Vistas indexadas
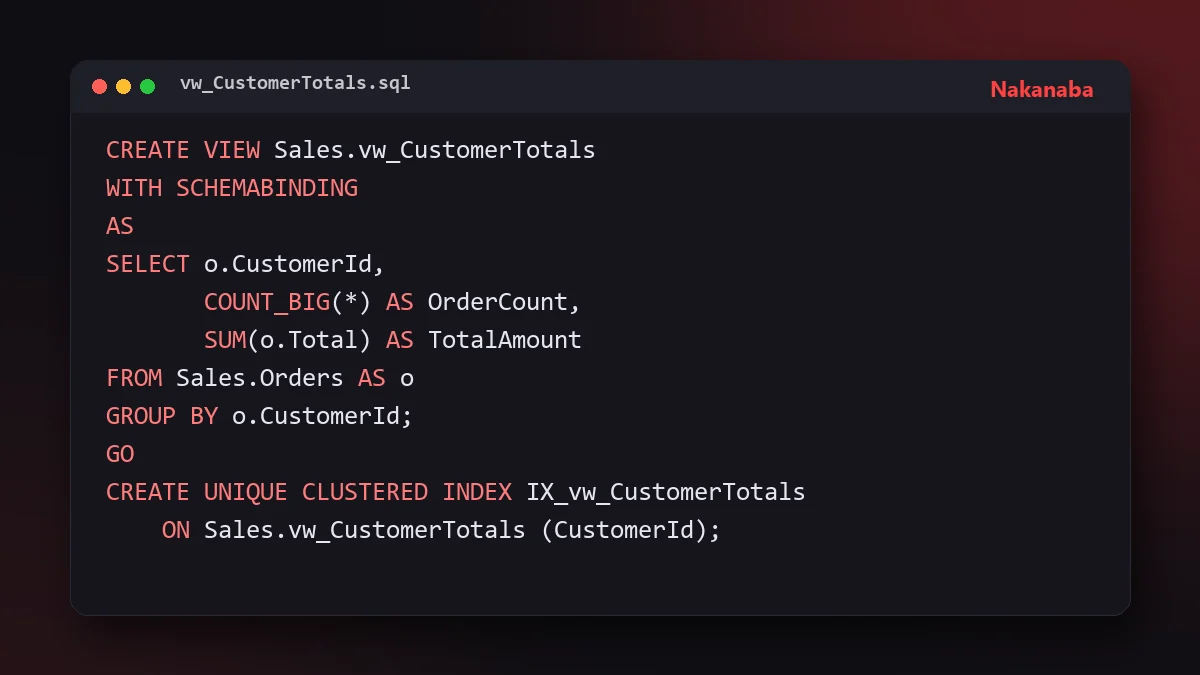
Para agregaciones entre tablas, una vista indexada guarda el resultado y SQL Server lo actualiza en cada escritura:
CREATE VIEW Sales.vw_CustomerTotals
WITH SCHEMABINDING
AS
SELECT o.CustomerId,
       COUNT_BIG(*) AS OrderCount,
       SUM(o.Total) AS TotalAmount
FROM Sales.Orders AS o
GROUP BY o.CustomerId;
GO

CREATE UNIQUE CLUSTERED INDEX IX_vw_CustomerTotals ON Sales.vw_CustomerTotals (CustomerId);
Consultar los totales por cliente pasa a ser una lectura directa. Las restricciones son varias: SCHEMABINDING, COUNT_BIG(*) si hay GROUP BY, SUM solo sobre columnas que no admiten NULL, nada de OUTER JOIN ni subconsultas, y cada escritura en Orders paga el costo de actualizar la vista. En una tabla con escrituras muy concurrentes, esa actualización puede volverse un punto de contención.
3. Copias mantenidas por la aplicación
Cuando lo anterior no alcanza, la aplicación guarda el valor duplicado:
ALTER TABLE Sales.Orders ADD ItemCount int NOT NULL CONSTRAINT DF_Orders_ItemCount DEFAULT (0);
Es la forma más flexible y la más frágil. Para que funcione:
- Un solo lugar escribe el valor. Si tres procesos distintos modifican líneas de pedido, los tres tienen que actualizar
ItemCount, y tarde o temprano uno no lo hará. - La actualización va en la misma transacción que el dato original.
- Hay una forma de recalcular todo desde la fuente si algo se desincroniza. Un script de verificación periódico que compare el valor guardado con el calculado detecta los problemas antes que los usuarios.
Un caso especial: los datos históricos
Hay datos que deben copiarse, y no por rendimiento: el precio de un producto en una factura. Si el precio cambia mañana, la factura de ayer no debe cambiar. Guardar UnitPrice en la línea del pedido no es desnormalización, es registrar un hecho del momento.
Lo mismo con la dirección de entrega de un pedido o el nombre del cliente en una factura legal. Distinguir entre "copia por rendimiento" y "hecho histórico" evita discusiones innecesarias sobre el modelo.
Modelos separados para leer
Si las necesidades de lectura y escritura son muy distintas, en lugar de desnormalizar el modelo transaccional se puede mantener un modelo de lectura aparte: tablas de resumen, un almacén analítico o una réplica con otro esquema. Es la idea detrás de CQRS, con sus propios costos de sincronización.
El trade-off
| Opción | Velocidad de lectura | Riesgo de inconsistencia | Costo en escrituras |
|---|---|---|---|
| Normalizado + índices | Buena | Ninguno | Bajo |
| Columna calculada persistida | Muy buena | Ninguno | Bajo |
| Vista indexada | Muy buena | Ninguno | Medio a alto |
| Copia en la aplicación | Máxima | Real | Medio |
Cuándo desnormalizar
- Cuando una consulta frecuente y crítica sigue siendo lenta después de optimizar índices y consultas.
- Cuando el dato duplicado cambia poco y se lee mucho.
- Cuando puedes garantizar un único punto de escritura y una forma de recalcular.
Cuándo no
- Por anticipación, "porque los JOIN son lentos", sin medirlo.
- Cuando el dato cambia con frecuencia y lo modifican muchos procesos.
- En tablas con mucha concurrencia de escritura, donde mantener la copia agrega contención.
Conclusión
Normalizar protege la consistencia; desnormalizar compra velocidad con esa consistencia. Antes de pagar ese precio, agota índices y consultas. Si aun así hace falta, prefiere las formas que mantiene el motor (columnas persistidas, vistas indexadas) y deja las copias manuales para cuando no quede otra opción, con un solo responsable de mantenerlas.


¿Tu base de datos se volvió lenta?
Revisamos consultas, índices y modelo de datos para que tu sistema responda rápido aunque los datos sigan creciendo.
Ver desarrollo a medida