GUID vs INT como Primary Key en SQL Server
INT es compacto y secuencial; GUID se genera en cualquier parte. Su efecto en índices y fragmentación, y por qué UUID v7 no basta en SQL Server.
Es una de las discusiones más repetidas en cualquier equipo que modela una base de datos: ¿la clave primaria es un int autoincremental o un GUID? Las dos opciones funcionan, y las dos tienen defensores con buenos argumentos. La respuesta depende de dónde se generan los identificadores y de qué tan grande va a ser la tabla.
INT / BIGINT con IDENTITY
CREATE TABLE Sales.Orders (
    OrderId int IDENTITY(1,1) NOT NULL CONSTRAINT PK_Orders PRIMARY KEY CLUSTERED,
    ...
);
A favor:
- 4 bytes (
int) u 8 (bigint). Como vimos en índices clustered y nonclustered, la clave del clustered se copia en todos los índices nonclustered: una clave pequeña hace todos los índices más pequeños. - Secuencial: las filas nuevas siempre van al final del índice, sin divisiones de página.
- Legible: "el pedido 10482" se puede dictar por teléfono.
En contra:
- Lo genera la base de datos. Para conocer el ID hay que insertar primero. Crear un pedido con sus líneas exige guardar el pedido, leer el ID y luego guardar las líneas (EF Core lo hace por ti, pero el viaje existe).
- Es predecible. Si la API expone
/api/orders/10482, cualquiera puede probar con 10483. Eso no es una vulnerabilidad por sí solo (para eso existe la autorización), pero revela información: cuántos pedidos tiene el sistema y a qué ritmo crece. - Difícil de combinar entre bases. Fusionar datos de dos bases, o generar registros sin conexión desde una aplicación móvil, produce colisiones.
inttiene un límite de unos 2.100 millones. En tablas de eventos o logs se alcanza más rápido de lo que parece; para ellas,bigintdesde el principio.
GUID (uniqueidentifier)
CREATE TABLE Sales.Orders (
    OrderId uniqueidentifier NOT NULL
        CONSTRAINT PK_Orders PRIMARY KEY CLUSTERED
        CONSTRAINT DF_Orders_OrderId DEFAULT NEWSEQUENTIALID(),
    ...
);
A favor:
- Se genera en cualquier parte: la aplicación, un cliente móvil sin conexión, otro sistema. El ID existe antes de tocar la base de datos.
- Único entre bases y sistemas: se pueden fusionar datos sin colisiones.
- No es enumerable: no revela cantidades ni permite adivinar el siguiente.
En contra:
- 16 bytes: cuatro veces un
int, en la clave y en cada índice nonclustered. - Fragmentación si los valores son aleatorios y el índice es clustered.
- Incómodo para personas: nadie dicta
3f2504e0-4f89-11d3-9a0c-0305e82c3301por teléfono.
El problema real: GUID aleatorio como índice clustered
Con NEWID() o Guid.NewGuid(), cada valor nuevo cae en una posición aleatoria del índice. SQL Server tiene que insertar en medio de páginas que ya están llenas, dividirlas y dejar espacio libre. El resultado:
- Más escrituras por cada inserción.
- Páginas medio vacías: el índice ocupa más espacio y más memoria.
- Mucha más fragmentación que con un valor secuencial.
En una tabla con pocas inserciones no importa. En una tabla con miles de inserciones por minuto, sí.
Opciones para tener GUID sin ese costo
NEWSEQUENTIALID() en la base de datos
Genera GUIDs crecientes en el servidor. Resuelve la fragmentación, pero devuelve la desventaja de que el ID lo genera la base de datos, y la secuencia puede reiniciar en otro punto después de un reinicio de Windows.
UUID v7 desde .NET 9, con un detalle importante
.NET 9 agregó Guid.CreateVersion7(): un GUID que empieza con una marca de tiempo, así que los valores generados después son mayores. Parece la solución perfecta, pero SQL Server no ordena uniqueidentifier byte por byte de izquierda a derecha: compara primero los últimos 6 bytes. Un UUID v7 es secuencial para .NET y para otros motores, pero en SQL Server no queda ordenado como esperas, y la fragmentación vuelve a aparecer.
Para SQL Server, la alternativa es generar en la aplicación GUIDs "secuenciales al estilo SQL Server", con la parte que cambia en los bytes que SQL Server compara primero. Algunas bibliotecas lo hacen (EF Core usa un generador así por defecto para las claves Guid en SQL Server).
Separar la clave clustered del identificador público
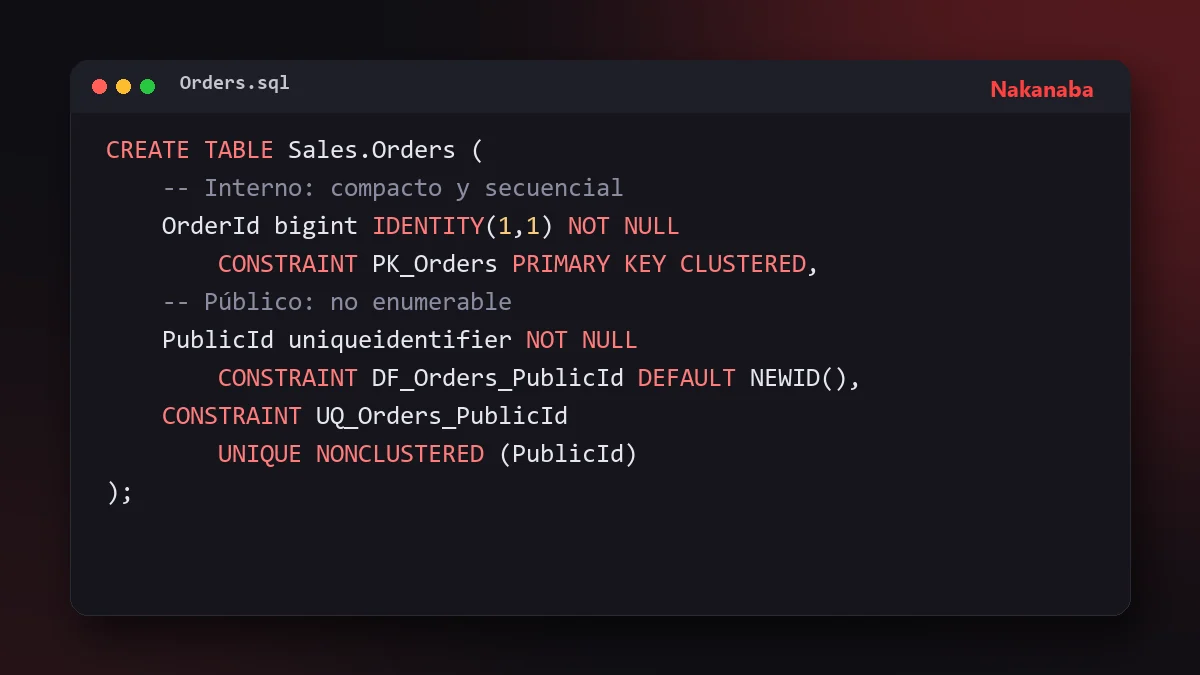
Una solución muy práctica cuando se necesita lo mejor de los dos:
CREATE TABLE Sales.Orders (
    OrderId bigint IDENTITY(1,1) NOT NULL CONSTRAINT PK_Orders PRIMARY KEY CLUSTERED,
    PublicId uniqueidentifier NOT NULL CONSTRAINT DF_Orders_PublicId DEFAULT NEWID(),
    ...
    CONSTRAINT UQ_Orders_PublicId UNIQUE NONCLUSTERED (PublicId)
);
- Internamente, joins e índices usan el
bigintcompacto y secuencial. - La API expone
PublicId, que no es enumerable. - El índice sobre
PublicIdse fragmenta, pero es uno solo y pequeño.
El costo: dos identificadores por entidad y cuidado para no exponer nunca el interno.
El trade-off
| INT / BIGINT | GUID aleatorio | GUID secuencial | INT interno + GUID público | |
|---|---|---|---|---|
| Tamaño en índices | Mínimo | Grande | Grande | Mínimo |
| Fragmentación | Ninguna | Alta | Baja | Baja (solo índice público) |
| Generar sin la base de datos | No | Sí | Depende | El público, sí |
| Enumerable desde fuera | Sí | No | Parcialmente | No |
| Complejidad | Mínima | Baja | Media | Media |
Cuándo usar cada uno
- INT / BIGINT: sistemas con una sola base de datos, IDs que no se exponen o se protegen con autorización, y tablas con muchas escrituras.
- GUID secuencial: sistemas distribuidos, sincronización sin conexión, datos que se fusionan entre bases.
- INT interno + GUID público: APIs públicas donde no quieres IDs enumerables pero sí índices eficientes.
Cuándo no preocuparse
En tablas pequeñas o con pocas inserciones (catálogos, configuración, usuarios de un sistema interno), la diferencia de rendimiento es irrelevante. Elige lo que sea más cómodo para el sistema y ahorra la discusión para las tablas que reciben miles de filas por minuto.
Conclusión
No hay un ganador universal. int es compacto y rápido; GUID es flexible y no revela nada. Si eliges GUID como clave clustered en SQL Server, asegúrate de que sea secuencial para SQL Server, no solo para .NET. Y si necesitas lo mejor de los dos, separar el identificador interno del público es una solución probada y simple de mantener.


¿Tu base de datos se volvió lenta?
Revisamos consultas, índices y modelo de datos para que tu sistema responda rápido aunque los datos sigan creciendo.
Ver desarrollo a medida