Por qué una consulta SQL puede ser lenta
La consulta es la misma de siempre y de un día para otro tarda segundos. Las causas más comunes en SQL Server y cómo distinguir una de otra antes de tocar nada.
La consulta no cambió. Lleva meses en producción, respondía en milisegundos y nadie la ha tocado. Un lunes empieza a tardar cuatro segundos y el endpoint que la usa se convierte en el más lento de la API.
Casi siempre la primera reacción es agregar un índice. A veces funciona. Muchas otras no, porque el problema no era la falta de un índice sino algo que impedía usarlo, un plan de ejecución que dejó de servir o una consulta que simplemente está esperando a otra.
Antes de cambiar nada, conviene saber en cuál de esos casos estás.
Primero: ¿está trabajando o está esperando?
Una consulta lenta puede estar consumiendo recursos (leyendo millones de páginas, ordenando en memoria) o esperando (un bloqueo, disco, memoria). Las soluciones son completamente distintas.
Mientras la consulta se ejecuta, esto te dice qué está haciendo:
SELECT r.session_id, r.status, r.wait_type, r.wait_time,
       r.blocking_session_id, r.logical_reads, r.cpu_time,
       t.text
FROM sys.dm_exec_requests AS r
CROSS APPLY sys.dm_exec_sql_text(r.sql_handle) AS t
WHERE r.session_id <> @@SPID;
Si blocking_session_id tiene un valor, tu consulta no es lenta: está esperando a otra sesión. Agregar índices no lo va a resolver. Si logical_reads crece sin parar, está leyendo demasiado, y ahí sí estamos hablando del plan.
Causa 1: un predicado que impide usar el índice
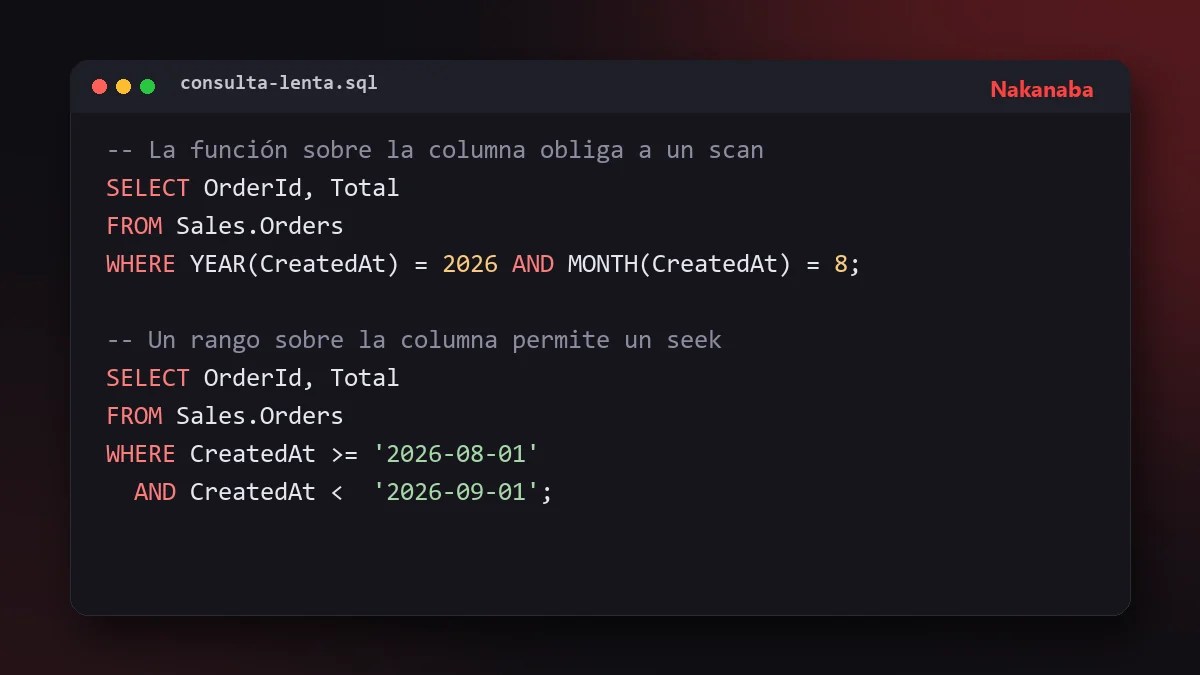
Es la más común y la más fácil de pasar por alto. El índice existe, pero la forma en que está escrita la condición obliga a SQL Server a evaluar fila por fila.
-- ❌ La función sobre la columna obliga a recorrer todo el índice
SELECT OrderId, Total
FROM Sales.Orders
WHERE YEAR(CreatedAt) = 2026 AND MONTH(CreatedAt) = 8;

-- ✅ Un rango sobre la columna permite un seek
SELECT OrderId, Total
FROM Sales.Orders
WHERE CreatedAt >= '2026-08-01' AND CreatedAt < '2026-09-01';
A esto se le llama una condición SARGable (que puede usar un argumento de búsqueda). Funciones sobre la columna, LIKE '%texto' con comodín al inicio y operaciones como Price * 1.19 > 100 rompen esa posibilidad.
Causa 2: conversiones implícitas
Muy parecida a la anterior, pero invisible en el código. Si la columna es varchar y el parámetro llega como nvarchar, SQL Server convierte la columna para poder comparar, y el índice deja de servir para un seek.
-- La columna Code es varchar(20)
DECLARE @code nvarchar(20) = N'ABC-123';

SELECT ProductId FROM Catalog.Products WHERE Code = @code; -- conversión implícita
Pasa mucho desde .NET: un string de C# se envía como nvarchar por defecto. En el plan de ejecución aparece como una advertencia CONVERT_IMPLICIT. La solución es declarar el tipo correcto del parámetro (DbType.AnsiString en Dapper, o HasColumnType("varchar(20)") en EF Core).
Causa 3: parameter sniffing
SQL Server compila el plan con los valores del primer parámetro que recibe y lo reutiliza. Si el primer cliente que consultó tenía 10 pedidos, el plan es perfecto para 10 filas. Cuando llega un cliente con 2 millones, se usa el mismo plan y la consulta se arrastra.
El síntoma típico: "a veces es rápida y a veces es lenta, con la misma consulta". O: "se arregló sola después de reiniciar", porque se limpió la caché de planes.
Hay varias salidas, cada una con su costo:
-- Recompila en cada ejecución: plan óptimo, pero cuesta CPU
SELECT ... WHERE CustomerId = @customerId
OPTION (RECOMPILE);

-- Optimiza para un valor "promedio" según las estadísticas
SELECT ... WHERE CustomerId = @customerId
OPTION (OPTIMIZE FOR UNKNOWN);
RECOMPILE es razonable en consultas que se ejecutan pocas veces por minuto. En una consulta que corre miles de veces por segundo, el costo de compilar se nota. Desde SQL Server 2022, Parameter Sensitive Plan optimization mantiene varios planes para una misma consulta y reduce este problema en muchos casos.
Causa 4: estadísticas desactualizadas
El optimizador decide el plan según cuántas filas cree que va a encontrar. Esa estimación sale de las estadísticas. En una tabla que creció mucho desde la última actualización, el optimizador puede creer que vienen 100 filas cuando vienen 500.000, y elegir un plan pensado para pocas.
En el plan de ejecución se ve como una diferencia grande entre Estimated Number of Rows y Actual Number of Rows. Actualizar las estadísticas de la tabla suele resolverlo:
UPDATE STATISTICS Sales.Orders WITH FULLSCAN;
Causa 5: traer más de lo que necesitas
SELECT * en una tabla con columnas nvarchar(max) o JSON obliga a leer muchas más páginas, impide usar índices que cubren la consulta y aumenta el tráfico de red. Lo mismo pasa con una consulta que devuelve 50.000 filas para mostrar 20 en pantalla.
Antes de optimizar el motor, pregúntate si la consulta debería traer todo eso.
Causa 6: key lookups en volumen
Un índice no agrupado encuentra las filas rápido, pero si la consulta pide columnas que no están en el índice, SQL Server tiene que ir a buscarlas a la tabla una por una. Con 20 filas es irrelevante. Con 200.000 es la mitad del tiempo de la consulta. En el plan aparece como Key Lookup con un costo alto. La solución suele ser un índice que cubra la consulta, algo que conviene decidir con el plan de ejecución en la mano.
Cómo distinguir la causa
| Síntoma | Causa probable |
|---|---|
blocking_session_id con valor |
Bloqueo: busca la sesión que bloquea |
| Rápida a veces, lenta otras, mismo SQL | Parameter sniffing |
| Estimadas y reales muy distintas en el plan | Estadísticas o predicado mal escrito |
CONVERT_IMPLICIT en el plan |
Tipo de parámetro incorrecto |
| Index Scan donde esperabas Seek | Predicado no SARGable o falta de índice |
| Key Lookup con costo alto | Índice que no cubre la consulta |
El trade-off de "arreglarlo con un índice"
Cada índice acelera algunas lecturas y encarece todas las escrituras de la tabla: cada INSERT, UPDATE y DELETE tiene que mantenerlo. En una tabla de pedidos que recibe cientos de escrituras por segundo, cinco índices de más se notan.
Por eso conviene confirmar la causa antes. Un índice nuevo sobre una consulta que estaba bloqueada no la acelera; solo agrega trabajo a las escrituras.
Cuándo no vale la pena optimizar
Si la consulta corre una vez al día en un proceso nocturno y tarda 8 segundos, probablemente hay mejores lugares donde invertir el tiempo. La optimización tiene sentido donde el costo se multiplica: consultas frecuentes, endpoints con mucho tráfico o procesos que bloquean a otros.
Conclusión
Una consulta lenta casi nunca se arregla adivinando. Primero se confirma si está trabajando o esperando; después, el plan de ejecución dice el resto. Con esas dos respuestas, la solución suele ser evidente y mucho más pequeña de lo que parecía.


¿Tu base de datos se volvió lenta?
Revisamos consultas, índices y modelo de datos para que tu sistema responda rápido aunque los datos sigan creciendo.
Ver desarrollo a medida